DE
 EN
Von wiederverwendbaren Dimensionen über intelligente Datenmodellierung bis hin zu KI: Warum Datenmodule heute die Grundlage einer modernen BI-Architektur bilden.
Mit IBM Cognos Analytics 12.2 ist es wieder Zeit, über die Datenmodellierung zu sprechen. Und diesmal möchte ich die Frage etwas anders stellen.
In den vergangenen Jahren haben wir immer wieder diskutiert, welche Funktionen der Framework Manager bietet, die in Datenmodulen noch fehlen. Diese Diskussion war lange berechtigt, denn Framework Manager war über viele Jahre das etablierte Werkzeug für professionelle Cognos-Datenmodelle.
Inzwischen hat sich allerdings sehr viel verändert.
IBM hat die Datenmodule kontinuierlich weiterentwickelt. Viele frühere Einschränkungen wurden beseitigt. Andere Funktionen wurden durch modernere Konzepte ersetzt. Und mittlerweile bieten Datenmodule zahlreiche Möglichkeiten, die es im Framework Manager überhaupt nicht oder nur mit erheblich höherem Aufwand gibt.
Besonders spannend finde ich dabei gar nicht die einzelnen Funktionen. Es ist vielmehr die Möglichkeit, eine vollständig neue Modellierungsarchitektur aufzubauen: mit harmonisierten Dimensionen, wiederverwendbaren Datenmodulen, automatisierter Bereitstellung und einer gemeinsamen semantischen Grundlage für Reporting, Dashboards, Self-Service und KI.
Wer Datenmodule heute noch als einfaches Werkzeug für Excel-Anwender betrachtet, unterschätzt ihre Möglichkeiten gewaltig.
Schauen wir uns also an, was Cognos Analytics 12.2.x inzwischen zu bieten hat.
1. Eine moderne Architektur statt gigantischer Datenmodelle
Beginnen wir mit einer Funktion, die aus meiner Sicht zu den wichtigsten überhaupt gehört: Datenmodule können auf anderen Datenmodulen aufbauen.
In vielen Unternehmen existieren umfangreiche Framework-Manager-Modelle mit Hunderten oder sogar Tausenden von Objekten. Sie enthalten Daten für Vertrieb, Finanzen, Personal, Produktion und zahlreiche weitere Bereiche.
Solche Modelle sind über Jahre gewachsen. Das hat Vorteile, insbesondere bei der zentralen Verwaltung von Kennzahlen und Dimensionen. Gleichzeitig werden diese Modelle zunehmend aufwendig in der Pflege.
Mit Datenmodulen können wir einen anderen Weg wählen.
Statt sämtliche Tabellen und Berechnungen in einem riesigen Modell zusammenzuführen, erstellen wir kleinere, fachlich abgegrenzte Datenmodule, die aufeinander aufbauen.
Harmonisierte Dimensionen einmal modellieren
Ein besonders sinnvoller Ansatz besteht darin, zunächst ein Datenmodul mit den gemeinsamen Dimensionen des Unternehmens aufzubauen.
Darin befinden sich beispielsweise die Dimensionen Zeit, Organisation, Produkt und Kunde.
Hier werden die fachlichen Definitionen zentral gepflegt: Schlüssel, Bezeichnungen, Berechnungen, Sortierungen, Spaltenabhängigkeiten und weitere Metadaten.
Anschließend erstellen wir für jeden Fachbereich ein eigenes Datenmodul.
Das Vertriebsmodell verwendet die gemeinsamen Dimensionen und ergänzt die Faktentabelle für Umsätze.
Das Personalmodell verwendet die Dimensionen Zeit und Organisation und ergänzt seine Personalfakten.
Das Finanzmodell verwendet ebenfalls die relevanten gemeinsamen Dimensionen und ergänzt die Finanzdaten.
Die Dimensionen müssen nicht erneut modelliert oder kopiert werden. Sie werden als verknüpfte Objekte aus dem zentralen Datenmodul übernommen.
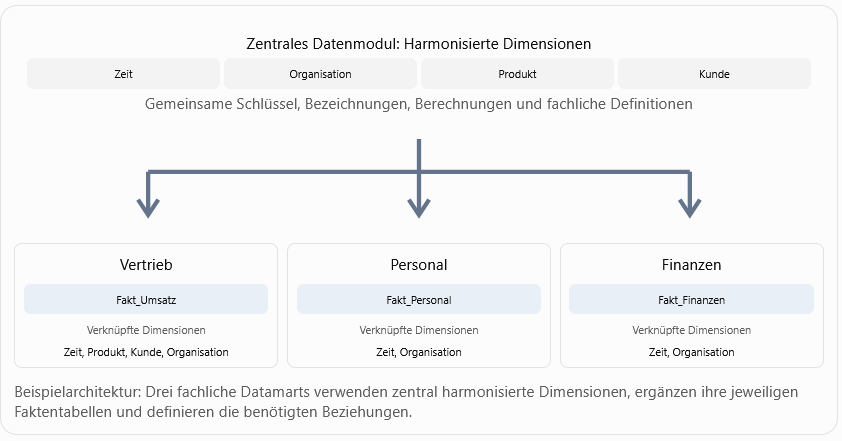
Hier die bereits erstellte Grafik „Zentrales Datenmodul: Harmonisierte Dimensionen“ mit den vier Dimensionen Zeit, Organisation, Produkt und Kunde sowie den drei darauf aufbauenden Datamarts Vertrieb, Personal und Finanzen einsetzen.
Bildunterschrift: Eine gemeinsame semantische Grundlage für mehrere fachliche Datamarts. Jede Faktentabelle ergänzt die benötigten, zentral gepflegten Dimensionen.
Änderungen zentral pflegen
Der große Vorteil zeigt sich spätestens bei der Wartung.
Wird beispielsweise eine Berechnung oder eine Bezeichnung in einer gemeinsam verwendeten Dimension geändert, können die verknüpften Datenmodule diese Änderung übernehmen.
Die entsprechenden Tabellen bleiben mit dem Quelldatenmodul verbunden.
Auch bereits modellierte Beziehungen können als referenzierte Beziehungen übernommen werden. Neue Beziehungen zwischen den gemeinsamen Dimensionen und den jeweiligen Faktentabellen werden im fachlichen Datenmodul ergänzt.
Das erleichtert die Zusammenarbeit mehrerer Modellierer erheblich.
Natürlich müssen Änderungen an zentralen Dimensionen sorgfältig getestet werden. Eine geänderte Schlüsselstruktur kann Auswirkungen auf mehrere Datamarts haben.
Aber genau deshalb ist die zentrale Pflege so sinnvoll: Fachliche Definitionen werden an einer Stelle verwaltet, statt in zahlreichen unabhängigen Modellen auseinanderzulaufen.
Auch mehrstufige Modelle sind möglich
Die Verschachtelung muss nicht bei zwei Ebenen enden.
Ein bestehendes Vertriebsdatenmodul kann beispielsweise wieder die Grundlage für ein spezielles Vertriebscontrolling-Modell bilden.
Dort werden zusätzliche Planungsdaten, Berechnungen oder fachbereichsspezifische Filter ergänzt.
Damit können wir zwischen unternehmensweit harmonisierten Daten, fachlichen Datamarts und speziellen Analyseanforderungen unterscheiden.
Die physischen Daten müssen dafür nicht mehrfach gespeichert werden. Zunächst werden lediglich die Modellierungsobjekte referenziert.
Wichtig ist allerdings, die Anzahl der Modellierungsebenen überschaubar zu halten. Auch IBM weist darauf hin, dass sehr tiefe Verschachtelungen die Fehlersuche und Wartung erschweren können.
Für mich ist diese modulare Architektur einer der größten Fortschritte gegenüber der klassischen Arbeit mit großen, zentralen Framework-Manager-Modellen.
Und das Beste: Die Erstellung solcher Datenmodule lässt sich auch automatisieren. Dazu später mehr.
2. Intent Modeling: Cognos hilft bei der Erstellung des Datenmodells
Datenmodule bieten bereits beim Einstieg eine interessante Unterstützung.
Über Intent Modeling kann Cognos geeignete Tabellen für einen bestimmten fachlichen Anwendungsfall vorschlagen.
Dazu analysiert das System Metadaten, Tabellennamen, Spalten, Datentypen und statistische Eigenschaften.
Der Anwender wählt passende fachliche Begriffe aus einer Wortwolke oder gibt eigene Suchbegriffe ein.
Anhand dieser Informationen schlägt Cognos Tabellen vor und versucht, Fakten- und Dimensionstabellen zu erkennen.
Im Idealfall entsteht daraus bereits ein geeignetes Stern- oder Schneeflockenschema.
Die Vorschläge werden mit einer Konfidenzbewertung angezeigt und können übernommen oder angepasst werden.
Das ist besonders hilfreich, wenn Fachanwender oder Modellierer eine größere Datenbank noch nicht vollständig kennen.
Natürlich muss ein vorgeschlagenes Modell fachlich überprüft werden. Automatische Modellierung ersetzt kein Verständnis der Daten.
Aber es ist bemerkenswert, wie viel Unterstützung Cognos inzwischen bereits bei der Erstellung eines neuen Datenmoduls bietet.
[BILD 2 – INTENT MODELING]
Screenshot des Intent Modeling mit Wortwolke und automatisch vorgeschlagenem Datenmodell.
Bildunterschrift: Cognos unterstützt die Modellierung durch die automatische Erkennung fachlich passender Tabellen und Beziehungen.
3. Automatische Beziehungen und komplexe Joins
Nach dem Auswählen der Tabellen müssen die Beziehungen definiert werden.
Auch dabei hilft Cognos.
Der Autojoin-Algorithmus untersucht unter anderem Spaltennamen, Datentypen, semantische Eigenschaften und die Überschneidung von Werten.
Daraus werden geeignete Join-Spalten und Kardinalitäten vorgeschlagen.
Die Ergebnisse lassen sich im grafischen Beziehungsdiagramm überprüfen und anpassen.
Komplexe Joins sind längst möglich
Ein früher häufig genanntes Argument gegen Datenmodule waren komplexe Join-Bedingungen.
Inzwischen ist das überholt.
Seit Cognos Analytics 12.1.1 steht ein eigener Relationship Expression Editor zur Verfügung.
Damit können Beziehungen über frei definierte Ausdrücke erstellt werden.
Beispielsweise kann eine Beziehung nicht nur über eine Kostenstellen-ID, sondern zusätzlich anhand eines Gültigkeitszeitraums definiert werden.
Der tatsächlich mögliche Ausdruck hängt natürlich von der beteiligten Datenquelle und der Abfrageverarbeitung ab.
Datenmodule bieten darüber hinaus die Definition von Join-Typen, Kardinalitäten und Optionen zur Join-Optimierung.
Gerade bei unterschiedlichen Datenquellen ist das interessant. Cognos kann Schlüsselwerte aus einer Datenquelle ermitteln und als Filter an die andere Datenquelle weitergeben.
Dadurch lässt sich die Anzahl der Datensätze reduzieren, die zur lokalen Verarbeitung übertragen werden müssen.
Für die Kombination verschiedener Datenbanksysteme oder ergänzender Fachbereichsdaten kann dies einen erheblichen Performancevorteil bieten.
Brückentabellen und unterschiedliche Granularitäten
Auch professionelle Modellierungsszenarien mit Many-to-many-Beziehungen werden unterstützt.
Datenmodule besitzen dafür unter anderem die Tabellenverwendung „Bridge“.
Damit wird dem Query Service mitgeteilt, dass eine Tabelle eine Brückentabelle und keine gewöhnliche Faktentabelle darstellt.
Auch zusammenfassende Tabellen können über entsprechende Eigenschaften modelliert werden.
Das sind wichtige Funktionen für professionelle relationale Modelle und keineswegs nur für einfache Self-Service-Anwendungen.
4. Spaltenabhängigkeiten: Determinanten gibt es auch in Datenmodulen
Wer lange mit Framework Manager gearbeitet hat, kennt die Determinanten.
Damit lassen sich funktionale Abhängigkeiten und unterschiedliche Granularitäten innerhalb einer Tabelle beschreiben.
In Datenmodulen heißt diese Funktion Column Dependencies, also Spaltenabhängigkeiten.
Sie erfüllt dieselbe grundlegende Aufgabe und kann sogar mehrere Abhängigkeitshierarchien pro Tabelle abbilden.
Ein einfaches Beispiel:
In einer Tabelle befinden sich Tagesumsätze und Monatsplanzahlen.
Die Monatsplanzahl darf bei einer Aggregation nicht für jeden einzelnen Tag erneut summiert werden.
Spaltenabhängigkeiten helfen Cognos dabei, die tatsächliche Granularität der Werte zu berücksichtigen und Doppelzählungen zu vermeiden.
IBM zeigt im Handbuch genau solche Beispiele.
Für Modelle mit unterschiedlichen Fakten und Aggregationsebenen ist dies eine zentrale Funktion.
Dabei ist wichtig, dass Spaltenabhängigkeiten fachlich korrekt definiert werden. Sie werden für bestimmte Quelltabellen automatisch angelegt, müssen bei strukturellen Änderungen oder benutzerdefinierten Tabellen aber gegebenenfalls angepasst werden.
Ein vermeintlicher Vorteil des Framework Managers ist also längst auch in Datenmodulen vorhanden – nur unter einem anderen Namen.
5. Navigationspfade: Drill-down ohne starre Hierarchien
Eine Funktion, die ich besonders schätze, sind die Navigationspfade.
Im Framework Manager werden für eine multidimensionale Navigation häufig DMR-Modelle mit Dimensionen, Ebenen und Hierarchien erstellt.
Das ist leistungsfähig, aber nicht für jede Analyse notwendig.
Datenmodule bieten mit ihren Navigationspfaden einen wesentlich flexibleren Ansatz.
Natürlich können wir klassische Hierarchien definieren, beispielsweise Jahr, Quartal, Monat und Tag oder Produktgruppe, Produktreihe und Produkt.
Das Besondere ist jedoch: Die Spalten eines Navigationspfades müssen überhaupt keine echte fachliche Hierarchie bilden.
Wir können beliebige fachlich sinnvoll kombinierbare Attribute miteinander verbinden, sogar aus unterschiedlichen Tabellen.
Beispiel: Was kaufen Kunden über welche Bestellmethode?
Stellen wir uns einen Navigationspfad vor:
Bestellmethode ? Produktreihe ? Produkt
Ein Anwender beginnt mit einem Diagramm, das den Umsatz nach Bestellmethode darstellt.
Er erkennt beispielsweise, wie viel Umsatz über Onlinebestellungen, Telefonbestellungen oder den Außendienst erzielt wurde.
Nun führt er einen Drill-down auf eine Bestellmethode durch.
Cognos zeigt anschließend, welche Produktreihen über diese Bestellmethode gekauft wurden.
Ein weiterer Drill-down führt zu den einzelnen Produkten.
Das Interessante daran: Bestellmethode und Produktreihe gehören normalerweise zu zwei unterschiedlichen Dimensionen. Sie bilden keine klassische Eltern-Kind-Hierarchie.
Trotzdem können wir sie in einem Navigationspfad zusammenführen.
Das Gleiche funktioniert beispielsweise mit Produkt, Kunde, Bundesland und Stadt. IBM nennt sogar genau diese Kombination als Beispiel in seinem Handbuch.
Wir können mehrere Navigationspfade definieren und dieselben Spalten in verschiedenen Pfaden verwenden.
Die Anwender können dann der vorgeschlagenen Reihenfolge folgen oder gezielt zu einer anderen Spalte des Navigationspfades wechseln.
Natürlich müssen die zugrunde liegenden Tabellen fachlich korrekt miteinander verbunden sein. Ein Navigationspfad ersetzt keine fehlenden Tabellenbeziehungen.
Aber für sehr viele typische Drill-down-Anforderungen ist eine vollständige DMR-Modellierung damit schlicht nicht mehr erforderlich.
[BILD 3 – FLEXIBLE NAVIGATIONSPFADE]
Beispiel eines Cognos-Dashboards: Erst Umsatz nach Bestellmethode, darunter das Drill-down-Ergebnis nach Produktreihe und anschließend nach Produkt. Die ausgewählte Bestellmethode sollte als Filter erkennbar sein.
Bildunterschrift: Navigationspfade erlauben den Wechsel zwischen unterschiedlichen fachlichen Dimensionen – auch ohne klassische Dimensionshierarchie.
6. Endlich richtig sortieren: Januar, Februar, März
Eine scheinbar kleine Funktion hat im Alltag eine enorme Bedeutung: die individuelle Sortierung von Attributen.
Wir alle kennen das Problem.
Eine Auswertung enthält Monatsnamen, aber diese werden alphabetisch sortiert:
April, August, Dezember, Februar, Januar …
Fachlich richtig wäre natürlich:
Januar, Februar, März, April, Mai …
Datenmodule bieten dafür mehrere Möglichkeiten.
Automatische Sortierung: Cognos kann Monatsnamen, Wochentage und Jahreszeiten erkennen und automatisch eine passende chronologische Sortierung erzeugen.
Manuelle Sortierung: Mit „Custom Sort Order“ lassen sich Werte in eine beliebige Reihenfolge bringen.
Sortierung anhand einer weiteren Spalte: Ein Monatsname wird beispielsweise anhand seiner numerischen Monatsnummer sortiert.
Dasselbe gilt für Statuswerte, Prioritäten, Prozessphasen oder andere fachliche Reihenfolgen.
Bei der manuellen Sortierung werden bis zu 100 Mitglieder unterstützt. Für größere Wertemengen kann ein Sortierindex verwendet werden.
Besonders interessant ist, dass die Sortierdefinition in den Metadaten des Datenbankschemas beziehungsweise der hochgeladenen Datei gespeichert wird.
Damit können auch andere Datenmodule, die dieselbe Quelle verwenden, von dieser Definition profitieren.
Die einmal definierte fachliche Sortierung muss also nicht in jedem Datamart erneut gepflegt werden.
Framework Manager kennt zwar Mitgliedersortierungen innerhalb von DMR-Dimensionen. Eine vergleichbar komfortable zentrale Sortierung beliebiger relationaler Attribute bietet er jedoch nicht.
[BILD 4 – CUSTOM SORT ORDER]
Gegenüberstellung einer alphabetisch falsch sortierten Monatsdarstellung und der benutzerdefinierten chronologischen Sortierung. Optional ergänzt durch einen Screenshot des Cognos-Sortiereditors.
Bildunterschrift: Fachlich korrekte Reihenfolgen werden einmal definiert und anschließend zentral wiederverwendet.
7. Relative Zeiträume und Kalenderlogik zentral definieren
Kaum eine BI-Anwendung kommt ohne Zeitvergleiche aus.
Aktuelles Jahr, Vorjahr, Year-to-Date, Vorjahr Year-to-Date, laufender Monat oder rollierende Zeiträume gehören zum Standard jeder Unternehmensanalyse.
Datenmodule bieten dafür die sogenannten Relative Date Calendars.
Nach der Zuordnung einer geeigneten Datumsspalte zu einem relativen Kalender können zahlreiche Zeitfilter und zeitbezogene Kennzahlen verwendet werden.
Damit lassen sich unter anderem Current Year (CY), Prior Year (PY), Year-to-Date (YTD), Prior Year-to-Date (PYTD) und andere Zeiträume abbilden.
Auch Geschäftsjahreskalender können berücksichtigt werden.
Besonders interessant ist die Möglichkeit, ein dynamisches Referenzdatum zu verwenden.
Über den globalen Parameter _as_of_date kann festgelegt werden, auf welches Datum sich die zeitlichen Berechnungen beziehen sollen.
Das erleichtert beispielsweise historische Stichtagsanalysen oder die Simulation einer Berichtsausführung zu einem früheren Zeitpunkt.
Der Vorteil liegt erneut in der zentralen Modellierung.
Die Berechnung des Vorjahres oder der kumulierten Jahreswerte muss nicht in jedem einzelnen Bericht neu entwickelt werden.
Zusätzlich unterstützt Cognos die Performance solcher Abfragen durch spezielle Optimierungen relativer Datumskennzahlen.
8. Zentrale Filter, intelligente Prompts und Datengruppen
Datenmodule ermöglichen es, fachliche Filter zentral bereitzustellen.
Dabei wird zwischen eingebetteten und auswählbaren Filtern unterschieden.
Ein eingebetteter Filter wird grundsätzlich auf die betreffende Tabelle angewendet.
Ein auswählbarer Filter steht dagegen den Anwendern als zusätzliche Auswahl im Datenmodul zur Verfügung.
Denkbar sind beispielsweise Filter für aktive Kunden, aktuelle Produkte, bestimmte Geschäftsjahre oder freigegebene Organisationseinheiten.
Die Anwender müssen diese Filter nicht selbst programmieren, sondern können die fachlich vorbereiteten Definitionen verwenden.
Anzeigewert und Filterwert müssen nicht identisch sein
Eine weitere wichtige Funktion ist die Eigenschaft „Filter nach“.
Damit kann beispielsweise ein Monatsname angezeigt werden, während Cognos intern nach der numerischen Monatsnummer filtert.
Der Anwender wählt also „Januar“, die Abfrage verwendet den Wert 1.
Das ist auch für die automatische Erstellung von Eingabeaufforderungsseiten im Reporting relevant.
Zusätzliche Parameter und Eingabeaufforderungen lassen sich über Makros wie prompt() und promptmany() definieren.
Parameter Maps aus dem Framework Manager können häufig durch Mapping-Tabellen und die Makrofunktion queryValue() ersetzt werden.
Data Groups: Werte ohne Programmierung zusammenfassen
Auch die interaktive Gruppierung von Daten ist direkt im Datenmodul möglich.
Kunden können beispielsweise nach Umsatzklassen, Mitarbeiter nach Altersbereichen oder Produkte nach frei definierten Kategorien gruppiert werden.
Bei numerischen Werten lassen sich Wertebereiche automatisch erzeugen und anschließend anpassen.
Das ist besonders praktisch, wenn Fachanwender schnell zusätzliche Analysegruppen benötigen, ohne dafür neue Datenbanktabellen oder umfangreiche CASE-Ausdrücke zu erstellen.
9. Excel ist kein Fremdkörper mehr in der BI-Architektur
Kommen wir zu einem Thema, das mir schon lange wichtig ist: Excel.
Viele Unternehmen haben leistungsfähige Data Warehouses aufgebaut. Trotzdem werden in den Fachbereichen weiterhin Excel-Dateien verwendet.
Darin befinden sich Planungswerte, Budgets, Sonderkalkulationen, Zuordnungen oder andere ergänzende Informationen.
Und das wird sich vermutlich auch nicht ändern.
Die Frage sollte deshalb nicht lauten, wie wir Excel aus den Fachbereichen verbannen.
Viel wichtiger ist, wie wir diese Daten kontrolliert in unsere BI-Architektur integrieren.
Datenmodule bieten dafür ausgezeichnete Möglichkeiten.
Excel-Dateien können hochgeladen und unmittelbar mit bestehenden Datenbanktabellen verbunden werden.
Beispielsweise können die Planwerte aus einer Excel-Datei mit den Istwerten aus einem relationalen Data Warehouse kombiniert werden.
Über die Join-Optimierungen kann Cognos auch die Abfrageverarbeitung über unterschiedliche Datenquellen hinweg verbessern.
Excel-Uploads direkt in Db2 speichern
Noch interessanter ist die Möglichkeit, hochgeladene Dateien und Cognos Data Sets direkt in einer unterstützten Db2-Datenbank zu speichern.
Seit Cognos Analytics 12.0.2 unterstützt IBM hierfür einen eigenen Data Sets Store.
Bei entsprechender Konfiguration werden neu hochgeladene Dateien und Data Sets als relationale Tabellen in Db2 abgelegt.
Die Abfragen werden dann von Db2 verarbeitet, statt die Daten über den Parquet-basierten Compute Service abzufragen.
Das bietet zusätzliche Möglichkeiten für die Verarbeitung größerer Datenmengen.
Die Speicherung erfolgt in einer eigens dafür konfigurierten Db2-Umgebung, deren Tabellen durch Cognos verwaltet werden. Es handelt sich also nicht einfach um einen Upload in eine beliebige DWH-Tabelle.
Unterstützt werden dafür geeignete Db2-LUW- beziehungsweise Db2-Warehouse-Umgebungen mit entsprechender Konfiguration für analytische Workloads.
Excel-Dateien automatisch aktualisieren
Und damit sind wir noch nicht am Ende.
Über die Cognos REST-API können hochgeladene Dateien auch automatisiert erstellt oder ersetzt werden.
Ein Prozess kann beispielsweise regelmäßig neue Excel-Planungsdaten bereitstellen.
Die darauf basierenden Datenmodule bleiben erhalten und verwenden anschließend die aktualisierten Werte.
Solange die erforderliche Tabellenstruktur kompatibel bleibt, müssen die zugehörigen Berichte und Dashboards nicht jedes Mal neu erstellt werden.
Aus einem manuellen Excel-Upload wird damit eine automatisierbare und kontrollierte Datenversorgung.
Das halte ich für einen wesentlichen Fortschritt.
Denn wenn wir unseren Anwendern solche Möglichkeiten nicht anbieten, riskieren wir, dass sie ihre Fachbereichsanalysen vollständig außerhalb der BI-Plattform erstellen.
[BILD 5 – EXCEL UND DB2]
Architekturgrafik mit Excel-Dateien, automatisierter Aktualisierung über REST-API, Cognos Data Sets Store in Db2, relationalem DWH und gemeinsamem Datenmodul. Als Ergebnisse Reporting und Dashboards darstellen.
Bildunterschrift: Excel-Daten lassen sich automatisiert in eine zentral verwaltete BI-Architektur integrieren.
10. Datenaufbereitung und Custom Tables direkt im Datenmodul
Neben der Integration verschiedener Datenquellen bieten Datenmodule zahlreiche Möglichkeiten zur Datenaufbereitung.
So können beispielsweise Leerzeichen entfernt, Zeichenfolgen verändert, NULL-Werte behandelt oder bestimmte Spaltenwerte angepasst werden.
Auch grundlegende Berechnungen lassen sich unmittelbar über die Benutzeroberfläche erstellen.
Der Modellierer muss dafür nicht jede Transformation selbst in SQL programmieren.
Natürlich ersetzt dies kein professionelles ETL-Verfahren für ein unternehmensweites Data Warehouse.
Für ergänzende Fachbereichsdaten oder spezielle Anforderungen ist es jedoch ausgesprochen hilfreich.
Custom Tables: SQL-Modellierung über eine grafische Oberfläche
Noch interessanter sind die benutzerdefinierten Tabellen.
Damit können unter anderem Ansichten, Aliase, Joins, Unions, Intersects und Excepts erstellt werden.
Beispielsweise lassen sich die Umsätze mehrerer Gesellschaften über eine Union zu einer gemeinsamen fachlichen Tabelle zusammenführen.
Auch vorhandene Tabellen können über einen Join zu einer neuen logischen Tabelle kombiniert werden.
Diese Definitionen werden zentral im Datenmodul gespeichert und stehen anschließend allen darauf basierenden Berichten und Dashboards zur Verfügung.
Zusätzlich können Tabellen mit eigenem SQL erstellt werden.
Die Cognos-Modellierungsoberfläche unterstützt dabei IBM Query SQL, natives SQL und Pass-Through-SQL, jeweils mit den entsprechenden technischen Voraussetzungen.
Für größere Datenmodelle ist das ein großer Vorteil: Die fachliche Datenaufbereitung wird einmal definiert und nicht in jedem Bericht erneut aufgebaut.
[BILD 6 – CUSTOM TABLES]
Screenshot der grafischen Custom-Table-Modellierung mit einer Union oder einem Join. Idealerweise werden die Quelltabellen und die daraus entstehende logische Tabelle gezeigt.
Bildunterschrift: Komplexere Datenstrukturen können direkt im Datenmodul modelliert und wiederverwendet werden.
11. Unterschiedliche Datenquellen – auch vorhandene Cognos-Modelle
Datenmodule können verschiedenste Quellen kombinieren.
Dazu gehören relationale Datenserver, hochgeladene Dateien, Data Sets, andere Datenmodule und geeignete Framework-Manager-Packages.
Das ist besonders für Unternehmen interessant, die bereits eine umfangreiche Cognos-Landschaft besitzen.
Ein bestehendes relationales Framework-Manager-Package im Dynamic Query Mode kann beispielsweise als Quelle eines neuen Datenmoduls dienen.
Dadurch lassen sich vorhandene Modelle um zusätzliche Daten und Funktionen erweitern, ohne zunächst das gesamte Framework-Manager-Projekt ablösen zu müssen.
Auch OLAP-Cubes können als Grundlage für Datenmodule verwendet werden.
Seit Version 12.1.3 wurde die Multi-Cube-Unterstützung erweitert.
Ebenso hat IBM die Unterstützung von Stored Procedures verbessert.
Hier müssen natürlich die jeweiligen Möglichkeiten und Einschränkungen berücksichtigt werden. Die Einbindung vorhandener Cubes ist beispielsweise nicht mit der vollständigen DMR-Modellierung gleichzusetzen.
Trotzdem wird deutlich, dass Datenmodule längst nicht mehr auf einfache relationale Datenquellen beschränkt sind.
12. Metadatenverwaltung: Einfacher, flexibler und unabhängiger
Ein weiterer Unterschied zwischen Framework Manager und Datenmodulen zeigt sich bei der laufenden Wartung.
Wenn sich die Tabellenstruktur einer Datenbank ändert, kann ein entsprechend berechtigter Modellierer die Metadaten direkt im Datenmodul neu laden.
Neue Spalten lassen sich ergänzen, entfernte Spalten identifizieren und betroffene Modellobjekte anpassen.
Die erstmalige Bereitstellung eines Datenbankschemas erfolgt weiterhin durch die Administration. Für spätere Aktualisierungen können Modellierer aber entsprechende Rechte erhalten.
Metadata Snapshot
Besonders interessant ist der Metadata Snapshot.
Damit kann eine lokale Abbildung der Datenbankmetadaten im Datenmodul gespeichert werden.
Modellierer können auf dieser Basis weiterarbeiten, auch wenn die Datenbankmetadaten vorübergehend nicht verfügbar sind oder auf der Datenbankseite Änderungen vorgenommen werden.
Zudem müssen die Metadaten nicht bei jeder Modellierungsaktion erneut aus der Datenquelle gelesen werden.
Ein Snapshot enthält allerdings keine Geschäftsdaten. Für die spätere Berichtsausführung wird weiterhin Zugriff auf die entsprechenden Daten benötigt.
Das Erstellen und Aktualisieren des Snapshots erfordert Administratorrechte.
Quellen austauschen und Modelle weiterverwenden
Mit „Relink Sources“ können Datenmodule auf andere kompatible Datenquellen umgestellt werden.
Das ist beispielsweise beim Übergang von der Entwicklungs- zur Produktionsumgebung hilfreich.
Wenn die erforderlichen Tabellen, Schlüssel und Datentypen kompatibel sind, können bestehende Berechnungen und Beziehungen erhalten bleiben.
Noch flexibler sind die Dynamic Source Overrides.
Damit können Datenserververbindungen, Schemas oder Kataloge zur Laufzeit beispielsweise anhand von Sitzungsparametern ausgewählt werden.
Das ist besonders für mandantenfähige Anwendungen oder unterschiedliche Systemumgebungen interessant.
Auch Framework Manager kennt dynamische Datenquellen. In Datenmodulen lässt sich diese Funktion jedoch unmittelbar über die entsprechenden Eigenschaften im Browser konfigurieren.
13. Intelligente Metadaten und mehrsprachige Modelle
Datenmodule können Attribute mit zusätzlichen fachlichen Informationen versehen.
Beispielsweise kann definiert werden, dass ein Attribut ein Land, eine Stadt, eine geografische Region, einen Monat oder ein Jahr repräsentiert.
Diese Informationen werden von Cognos verwendet, um geeignete Visualisierungen vorzuschlagen und Funktionen wie Karten oder zeitbezogene Analysen zu unterstützen.
Damit wird aus einer technischen Spalte ein fachlich verständliches Attribut.
Gerade für Self-Service und KI ist das wichtig.
Eine Datenquelle sollte nicht nur technische Spaltennamen bereitstellen, sondern die Bedeutung der Daten möglichst eindeutig beschreiben.
Mehrsprachige Metadaten
Auch bei der Mehrsprachigkeit bieten Datenmodule interessante Möglichkeiten.
Bezeichnungen, Beschreibungen und zusätzliche Informationen können in mehreren Sprachen gepflegt werden.
Die Übersetzungen lassen sich aus externen Dateien oder Datenbanktabellen beziehen.
Dadurch müssen sprachliche Änderungen nicht zwangsläufig durch eine erneute Bearbeitung des Datenmoduls erfolgen.
Zusätzlich unterstützt Cognos die Verarbeitung mehrsprachiger Geschäftsdaten, beispielsweise über sprachabhängige Zeilen oder Spalten.
Je nach Anwendungsfall kann mithilfe von Makros und Mapping-Tabellen die geeignete Sprache ausgewählt werden.
Damit lassen sich auch international genutzte Datenmodelle zentral verwalten.
Der dokumentierte Funktionsumfang der dynamischen Metadatenübersetzungen ist allerdings nicht in allen Cognos-Komponenten identisch; insbesondere die Reporting-Unterstützung ist hier zu beachten.
14. Performanceoptimierung direkt im Datenmodell
Natürlich müssen auch Datenmodule die Anforderungen großer Unternehmensanwendungen erfüllen.
Dafür stehen mehrere Möglichkeiten zur Verfügung.
Neben der bereits erwähnten Join-Optimierung können beispielsweise Spaltenabhängigkeiten verwendet werden, um fehlerhafte Mehrfachaggregationen zu verhindern.
Auch Brückentabellen und Zusammenfassungstabellen lassen sich entsprechend kennzeichnen.
Daten-Caching
Das Caching kann auf Quellen- oder Tabellenebene konfiguriert werden.
Dabei lässt sich festlegen, ob Ergebnisse zwischengespeichert werden und wie lange sie gültig bleiben.
Auch eine Steuerung über Makros ist möglich.
Cognos kann identische oder kompatible Abfrageergebnisse wiederverwenden.
Wichtig ist, dass die Sicherheitskontexte berücksichtigt werden. Zwischengespeicherte Daten dürfen nicht einfach zwischen Anwendern mit unterschiedlichen Berechtigungen ausgetauscht werden.
Das Datenmodul-Caching gilt außerdem nicht für jede Quellenart gleichermaßen. Bei OLAP-Cubes, Data Sets und hochgeladenen Dateien gelten Einschränkungen.
Kontrolle der generierten SQL
Ein weiteres Detail ist die Eigenschaft „Elementliste“.
Damit kann gesteuert werden, ob Cognos bei der SQL-Generierung sämtliche Spalten einer Tabelle berücksichtigt oder nur die tatsächlich für eine Abfrage und ihre Joins benötigten Spalten.
Auch die erzeugte SQL lässt sich direkt aus der Modellierungsoberfläche untersuchen.
Zusätzlich stehen Datenvorschau, Ausdrucksvalidierung und eine grafische Darstellung der Beziehungen zur Verfügung.
Das ist wichtig, denn gute Performance entsteht nicht automatisch durch die Wahl des Modellierungswerkzeugs.
Sie entsteht durch eine fachlich und technisch saubere Modellierung.
Datenmodule stellen dafür inzwischen zahlreiche Werkzeuge bereit.
15. Self-Service bedeutet nicht, auf Governance zu verzichten
Ein häufiges Argument gegen Self-Service ist die Sorge, dass Anwender unkontrolliert Datenmodelle erstellen.
Das muss jedoch nicht so sein.
Datenmodule bieten verschiedene Möglichkeiten, Modellierungsrechte und Datenzugriffe zentral zu steuern.
Administratoren können beispielsweise für bestimmte Rollen die Bearbeitung von Beziehungen, Berechnungen oder Sicherheitsdefinitionen einschränken.
Ein Fachanwender kann dadurch zusätzliche Informationen in seinem Modell verwenden, ohne sämtliche zentralen Modellierungsfunktionen verändern zu dürfen.
Row-Level Security
Besonders wichtig ist die Möglichkeit, Datensicherheit bereits auf Ebene der Datenserver-Metadaten festzulegen.
Damit kann beispielsweise bestimmt werden, welche Regionen, Kostenstellen oder Organisationseinheiten ein Anwender sehen darf.
Die Sicherheitsdefinition wirkt dann auf Datenmodule, die dieselben geschützten Datenserverobjekte verwenden.
Das vermeidet die mehrfache Pflege identischer Sicherheitsregeln.
Allerdings muss das Sicherheitskonzept korrekt aufgebaut werden. Insbesondere benutzerdefinierte SQL-Zugriffe müssen gegebenenfalls administrativ eingeschränkt werden, da sie sonst Sicherheitsfilter umgehen könnten.
Das ist keine Besonderheit, die man ignorieren sollte, sondern ein wichtiger Bestandteil einer professionellen Governance.
Datenmodule direkt im Cognos-Portal
Ein weiterer Vorteil ist die Integration in die normale Cognos-Benutzeroberfläche.
Datenmodule werden wie Berichte oder Dashboards im Content Store gespeichert und können dort mit Berechtigungen versehen werden.
Ein separater Windows-Client ist nicht erforderlich.
Auch Änderungen müssen nicht erst über einen klassischen Package-Publishing-Prozess bereitgestellt werden.
Modellierer können Berechnungen und Beziehungen direkt testen und anschließend Berichte oder Dashboards auf Basis des gespeicherten Datenmoduls erstellen.
Der gesamte Entwicklungsprozess wird dadurch deutlich zugänglicher.
16. Automatisierung und Versionsverwaltung: Datenmodule als Teil eines Entwicklungsprozesses
Kommen wir noch einmal auf die modulare Architektur zurück.
Besonders interessant wird sie, wenn wir die Erstellung und Verwaltung der Datenmodule automatisieren.
Die Cognos REST-API ermöglicht es, Datenmodule anhand ihrer Modellspezifikationen zu erstellen und zu aktualisieren.
Damit können standardisierte Datamarts nach definierten Regeln aufgebaut werden.
Ein neuer fachlicher Datamart könnte beispielsweise automatisch die benötigten Dimensionen aus einem zentralen Datenmodul referenzieren und anschließend seine Faktentabellen ergänzen.
Auch Beziehungen, Berechnungen, Eigenschaften und weitere Modellbestandteile lassen sich grundsätzlich über die Modellspezifikation abbilden.
Natürlich müssen solche Generatoren sauber entwickelt und getestet werden. Die REST-API liefert die technischen Möglichkeiten, aber keine automatische Garantie für fachlich richtige Modelle.
Versionskontrolle mit Git
Mit der integrierten Source-Control-Unterstützung können Datenmodule außerdem in Git-Repositories versioniert werden.
Damit lassen sich Modelländerungen dokumentieren, verschiedene Versionsstände vergleichen und frühere Versionen wiederherstellen.
Zusammen mit automatisierten Deployments können Datenmodule so Teil eines geregelten Entwicklungsprozesses werden.
Das ist besonders für Unternehmen interessant, die mehrere Entwicklungs-, Test- und Produktionsumgebungen betreiben.
[BILD 7 – AUTOMATISIERTE DATAMART-ERSTELLUNG]
Architekturdiagramm: Zentrales Dimensionsmodell und Datamart-Vorlagen ? automatisierte Modellgenerierung über die Cognos REST-API ? Datenmodule Vertrieb, Personal und Finanzen ? Git-Versionierung und Bereitstellung.
Bildunterschrift: Wiederverwendbare Datenmodule ermöglichen eine standardisierte und weitgehend automatisierbare Datamart-Architektur.
Die technische Verwaltung wird damit zunehmend ähnlich wie bei anderen modernen Entwicklungsartefakten möglich.
Was weiterhin wichtig bleibt, ist eine professionelle Auswirkungsanalyse bei Änderungen. Git dokumentiert die Modellversionen, ersetzt aber nicht automatisch die vollständige Prüfung aller abhängigen Berichte.
17. KI unterstützt inzwischen auch die Modellierer
Die Möglichkeiten künstlicher Intelligenz beschränken sich nicht mehr auf die spätere Auswertung der Daten.
IBM entwickelt inzwischen Funktionen, die bereits bei der Datenmodellierung helfen.
Ein Beispiel ist die KI-gestützte Erstellung von Berechnungen.
Ein Modellierer kann in natürlicher Sprache beschreiben, welche Berechnung benötigt wird.
Denkbar sind beispielsweise Anfragen wie:
„Berechne den Gewinn pro verkauftem Artikel.“
Oder:
„Teile den Umsatz in fünf Größenklassen ein.“
Der Assistent kann daraus einen Berechnungsausdruck erzeugen und dessen Übernahme in das Datenmodul anbieten.
Diese Funktion ist in der IBM-Dokumentation noch als Preview beschrieben.
Der Funktionsumfang ist deshalb eingeschränkt. Unter anderem wird für die Erstellung solcher Berechnungen derzeit ein Datenmodul mit nur einer Datenquelle vorausgesetzt.
Die vorgeschlagenen Ausdrücke müssen selbstverständlich überprüft werden.
Trotzdem zeigt die Funktion sehr deutlich, wohin die Entwicklung geht.
Datenmodellierung wird zunehmend durch intelligente Assistenten unterstützt.
18. Die gemeinsame semantische Schicht wird für KI immer wichtiger
Aus meiner Sicht ist das der entscheidende strategische Punkt.
Mit Cognos Analytics 12.2 und den neuen KI-Funktionen gewinnt die semantische Modellierung eine völlig neue Bedeutung.
Bisher mussten wir dafür sorgen, dass Berichte und Dashboards die richtigen Kennzahlen, Beziehungen und Berechnungen verwenden.
Zukünftig müssen auch KI-Agenten verstehen, was unsere Unternehmensdaten bedeuten.
Dafür reichen technische Tabellen- und Spaltennamen nicht aus.
Ein KI-Agent muss wissen, welche Kennzahl den Umsatz darstellt, wie sich ein Geschäftsjahr definiert, welche Dimensionen miteinander verbunden werden können und welche Daten ein Anwender überhaupt sehen darf.
Genau dafür benötigen wir eine gut gepflegte semantische Schicht.
Der Query Agent in Cognos Analytics 12.2
Der neue Query Agent ermöglicht es, Fragen an Unternehmensdaten in natürlicher Sprache zu stellen.
Er kann daraus SQL-Abfragen erzeugen und Ergebnisse mit Visualisierungen und Erläuterungen bereitstellen.
IBM dokumentiert Datenmodule als unterstützte Datenquelle für diesen Agenten.
Damit wird die Entscheidung für die Modellierungsumgebung zunehmend auch zu einer Entscheidung darüber, welche neuen KI-Funktionen unmittelbar genutzt werden können.
Natürlich bedeutet das nicht, dass Framework-Manager-Packages grundsätzlich keine Rolle mehr für KI spielen.
Andere Cognos-Funktionen und Produkte wie watsonx BI können abhängig von ihrer technischen Konfiguration weiterhin Framework-Manager-Packages verwenden.
Auch die Verfügbarkeit des Query Agents hängt von Edition, Lizenzierung und Bereitstellung ab.
Trotzdem ist die Entwicklungsrichtung offensichtlich.
Reporting, Dashboards, Self-Service und KI nutzen dieselbe fachliche Grundlage
Stellen wir uns vor, ein Unternehmen pflegt seine Kennzahlen, Dimensionen und fachlichen Beschreibungen zentral in wiederverwendbaren Datenmodulen.
Ein Bericht nutzt diese Metadaten.
Ein Dashboard nutzt dieselben Definitionen.
Ein Fachanwender ergänzt auf dieser Grundlage eigene Excel-Daten.
Und ein KI-Agent verwendet die semantischen Informationen, um natürlichsprachliche Fragen zu interpretieren.
Die fachlichen Definitionen müssen dafür nicht in jedem Werkzeug erneut aufgebaut werden.
Das ist die eigentliche Stärke dieser Architektur.
Nicht jedes Analysewerkzeug verwaltet seine eigene Vorstellung von Umsatz, Kunden, Produktgruppen oder Zeiträumen.
Stattdessen entsteht eine gemeinsame semantische Grundlage.
Und je mehr KI-Funktionen hinzukommen, desto wertvoller wird diese einheitliche Modellierung.
[BILD 8 – GEMEINSAME SEMANTISCHE SCHICHT]
Grafik mit einem zentralen Datenmodul beziehungsweise einer modular aufgebauten semantischen Schicht. Davon führen Verbindungen zu Reporting, Dashboards, Exploration/Self-Service und KI-Agenten. Ergänzend können Datenserver, Excel und Data Sets als Quellen gezeigt werden.
Bildunterschrift: Die semantische Modellierung verbindet klassische Business Intelligence mit Self-Service und KI-gestützten Analysen.
19. Und Framework Manager? Jetzt immerhin auch mit 64 Bit!
Bei aller Begeisterung für Datenmodule möchte ich eine wichtige Neuerung des Framework Managers natürlich nicht unterschlagen.
Mit Cognos Analytics 12.2.0 steht Framework Manager erstmals als native 64-Bit-Anwendung zur Verfügung.
Das ist eine erfreuliche und längst überfällige Verbesserung.
Bisher war Framework Manager durch seine 32-Bit-Architektur beim adressierbaren Speicher begrenzt.
Gerade bei sehr großen Modellen konnte dies zu Problemen führen.
Die native 64-Bit-Version ermöglicht eine bessere Speichernutzung und kann die Stabilität und Performance bei umfangreichen Modellen verbessern.
Bestehende Modelle bleiben grundsätzlich weiterverwendbar. Ein Upgrade sollte wie üblich getestet werden.
Diese Verbesserung zeigt, dass IBM den Framework Manager weiterhin unterstützt.
Das ist wichtig, denn viele Unternehmen verfügen über umfangreiche und bewährte Modelle, die sie nicht kurzfristig ersetzen möchten.
Die 64-Bit-Umstellung ist jedoch eine technische Modernisierung und keine grundlegende Weiterentwicklung der Modellierungsfunktionen.
Hier liegt der wesentliche Unterschied zu Datenmodulen.
Während Framework Manager vor allem weiterhin bestehende Anwendungen unterstützt, kommen bei Datenmodulen regelmäßig neue Funktionen hinzu.
20. Welche Vorteile hat Framework Manager noch?
Bei einem solchen Vergleich muss natürlich auch die Frage gestellt werden, welche Funktionen weiterhin ausschließlich oder besser über Framework Manager verfügbar sind.
Aus meiner Sicht sind zwei Bereiche besonders relevant.
Objektsicherheit
Framework Manager erlaubt es, Berechtigungen auf einzelnen Modellobjekten zu definieren.
Dadurch kann gesteuert werden, welche Query Subjects oder Query Items bestimmte Anwender sehen dürfen.
Datenmodule unterstützen zwar Datensicherheit auf Werteebene, Berechtigungen auf Modulebene und eine differenzierte Steuerung der Modellierungsfunktionen.
Eine vollständig entsprechende rollenabhängige Objektsicherheit innerhalb desselben Datenmoduls steht jedoch nicht zur Verfügung.
Je nach Anwendung kann dies durch unterschiedliche Datenmodule, Berechtigungen auf Datenbankebene oder andere Sicherheitskonzepte gelöst werden.
Eine vollständige Gleichwertigkeit besteht aber nicht.
DMR-Modellierung
Der zweite wesentliche Bereich ist die vollständige Dimensionally Modeled Relational Modeling-Technologie.
Framework Manager ermöglicht eine multidimensionale Modellierung relationaler Daten mit Hierarchien, Ebenen, Mitgliedern und entsprechenden OLAP-Funktionen.
Datenmodule bieten zwar Navigationspfade, relative Zeitberechnungen und Zugriff auf unterstützte OLAP-Cubes.
Sie ersetzen jedoch nicht die gesamte DMR-Semantik.
Gerade bei komplexen memberbasierten Berechnungen, MDX und bestehenden dimensionalen Anwendungen kann Framework Manager deshalb weiterhin erforderlich sein.
Für sehr viele klassische Drill-down-Anforderungen reichen die flexiblen Navigationspfade der Datenmodule aber vollkommen aus.
Weitere Spezialfunktionen
Daneben existieren einzelne Unterschiede bei Funktionen wie dem direkten Import benutzerdefinierter Datenbankfunktionen, speziellen Prompt-Eigenschaften, bestimmten SAP-HANA-Szenarien oder der integrierten Analyse von Berichtsabhängigkeiten.
Teilweise gibt es alternative Verfahren, teilweise nicht vollständig gleichwertige Lösungen.
Diese Spezialfälle sollte man bei einer Migration prüfen.
Für die überwiegende Zahl neuer relationaler Anwendungen sind sie jedoch kein grundlegendes Argument gegen Datenmodule.
21. Die offizielle IBM-Vergleichsliste ist längst nicht mehr ausreichend
IBM veröffentlicht weiterhin eine Liste der Framework-Manager-Funktionen, die Datenmodule nicht oder nicht vollständig unterstützen.
Leider enthält diese Liste teilweise Aussagen, die durch neuere Cognos-Versionen überholt wurden.
Beispielsweise werden komplexe Joins weiterhin als Einschränkung dargestellt, obwohl es seit 12.1.1 den Relationship Expression Editor gibt.
Auch die Unterstützung von Datenmodulen im Event Agent ist inzwischen vorhanden.
Multi-Cube-Unterstützung, Stored Procedures und weitere Möglichkeiten wurden ebenfalls erweitert.
Andere Funktionen erscheinen nur deshalb als fehlend, weil sie in Datenmodulen anders umgesetzt werden.
Determinanten heißen beispielsweise Spaltenabhängigkeiten. Parameter Maps lassen sich häufig durch Mapping-Tabellen und queryValue() ersetzen. Namespaces sind aufgrund der eindeutigen Objektidentitäten nicht in derselben Weise erforderlich.
Das eigentliche Problem ist aber ein anderes.
Die Liste betrachtet fast ausschließlich, welche bekannten Framework-Manager-Funktionen bei Datenmodulen fehlen.
Die zahlreichen zusätzlichen Möglichkeiten der Datenmodule werden kaum berücksichtigt.
Dabei sind diese inzwischen entscheidend für die Wahl der Modellierungsumgebung.
Es wäre deshalb wünschenswert, wenn IBM die offizielle Gegenüberstellung vollständig überarbeiten würde.
Denn die Frage ist längst nicht mehr nur, ob Datenmodule den Framework Manager ersetzen können.
Die Frage lautet inzwischen, warum man bei neuen Anwendungen auf so viele Möglichkeiten verzichten sollte.
22. Muss man jetzt alle Framework-Manager-Modelle migrieren?
Nein, selbstverständlich nicht.
Funktionierende Anwendungen müssen nicht allein deshalb umgestellt werden, weil ein moderneres Werkzeug zur Verfügung steht.
Gerade große Framework-Manager-Modelle mit umfangreichen Berichtsabhängigkeiten, speziellen Sicherheitskonzepten oder DMR-Funktionen können weiterhin sinnvoll betrieben werden.
Die neue 64-Bit-Version verbessert dabei sogar ihre technische Perspektive.
Trotzdem würde ich bei jeder größeren Weiterentwicklung prüfen, ob neue fachliche Bereiche bereits mit Datenmodulen umgesetzt werden können.
Bestehende relationale Packages lassen sich unter bestimmten Voraussetzungen als Quellen für Datenmodule verwenden.
Dadurch können vorhandene Modelle weitergenutzt und schrittweise um neue Möglichkeiten ergänzt werden.
Eine vollständige Migration ist dafür nicht immer erforderlich.
Für neue relationale Modelle ist die Entscheidung aus meiner Sicht allerdings inzwischen eindeutig.
Fazit: Datenmodule sind die Grundlage einer modernen Cognos-Architektur
Wenn ich mir anschaue, wie sich die Datenmodule in den vergangenen Jahren entwickelt haben, ist das beeindruckend.
Anfangs waren sie vor allem als einfaches Werkzeug für Fachanwender gedacht.
Inzwischen verfügen sie über zahlreiche Funktionen für professionelle Unternehmensmodelle.
Automatische Modellierungsvorschläge, intelligente Beziehungen, komplexe Joins, Brückentabellen und Spaltenabhängigkeiten ermöglichen anspruchsvolle relationale Modelle.
Navigationspfade, individuelle Sortierungen, relative Zeitberechnungen, zentrale Filter und Datengruppen vereinfachen die spätere Analyse erheblich.
Excel-Uploads, Data Sets, die Speicherung in Db2 und automatisierte Aktualisierungen eröffnen völlig neue Möglichkeiten zur Integration von Fachbereichsdaten.
Metadata Snapshots, Quellenaustausch, mehrsprachige Metadaten und die Git-Versionierung unterstützen den professionellen Entwicklungsprozess.
Und mit KI-Funktionen wie dem Query Agent wird die semantische Modellierung zunehmend zur Grundlage einer völlig neuen Art der Datenanalyse.
Mein persönliches Highlight: Die modulare Datenmodellierung
Am meisten überzeugt mich aber weiterhin die Möglichkeit, Datenmodule wiederzuverwenden und ineinander zu verschachteln.
Wir müssen nicht mehr ein riesiges Modell entwickeln, in dem sämtliche Fachbereiche und Datenstrukturen zusammengefasst werden.
Stattdessen können wir gemeinsame Dimensionen einmal harmonisieren und anschließend für beliebig viele fachliche Datamarts verwenden.
Die jeweiligen Faktentabellen werden ergänzt, die Beziehungen definiert und die benötigten Kennzahlen bereitgestellt.
Das Ganze lässt sich standardisieren, versionieren und weitgehend automatisieren.
So entsteht eine BI-Architektur, die gleichzeitig zentral verwaltet und dezentral erweitert werden kann.
Genau das ist aus meiner Sicht der richtige Weg für moderne Business Intelligence.
Framework Manager bleibt ein bewährtes Werkzeug für bestehende Anwendungen und bestimmte Spezialanforderungen. Mit Cognos Analytics 12.2 hat es immerhin auch die wichtige Umstellung auf 64 Bit erhalten.
Die Innovationen der Datenmodellierung finden jedoch seit Jahren vor allem in den Datenmodulen statt.
Und mit einer gemeinsamen semantischen Grundlage für Reporting, Dashboards, Self-Service und KI wird ihre Bedeutung weiter zunehmen.
Meine Empfehlung ist deshalb klar: Wer heute eine neue relationale Cognos-Anwendung entwickelt, sollte mit Datenmodulen beginnen – und nur dann auf Framework Manager zurückgreifen, wenn konkrete Anforderungen es notwendig machen.
Ich werde diese Entwicklung auch bei den kommenden Cognos-Versionen weiterverfolgen. Denn die Frage, ob Datenmodule mit Framework Manager mithalten können, ist inzwischen eigentlich überholt.
Viel interessanter ist, welche neuen Möglichkeiten IBM als Nächstes hinzufügt.
Weiterführende IBM-Dokumentation
- Datenmodule – IBM Cognos Analytics 12.2.x
- Framework Manager Features not supported by Data Modules
- Model Design and Presentation – Modellierungsrichtlinien
- Metadata Snapshot
- Storing Data from Uploaded Files and Data Sets in Db2
- Cognos REST API – Überblick
- Source Control
- Agentic AI for Creating Calculations in Data Modules – Preview